Cos'è un PDF?
Immagini scansionate, testo rilevabile, OCR e perché i PDF costano di più con l'IA
8 settembre 2026
Contratti, atti, estratti conto, cartelle cliniche, fascicoli per il consiglio e raccoglitori di closing arrivano spesso come PDF, e appaiono identici su ogni macchina che li apre. Quella affidabilità è una delle ragioni principali della popolarità dei PDF.
È anche il motivo per cui i PDF frustrano quasi ogni compito che non sia guardarli. Convertirne uno in Word produce un pasticcio; cercare in un file scansionato non trova nulla; copiare una tabella produce una colonna di nonsense; e darne uno in pasto a uno strumento di IA costa diverse volte ciò che costerebbero le stesse parole come testo.
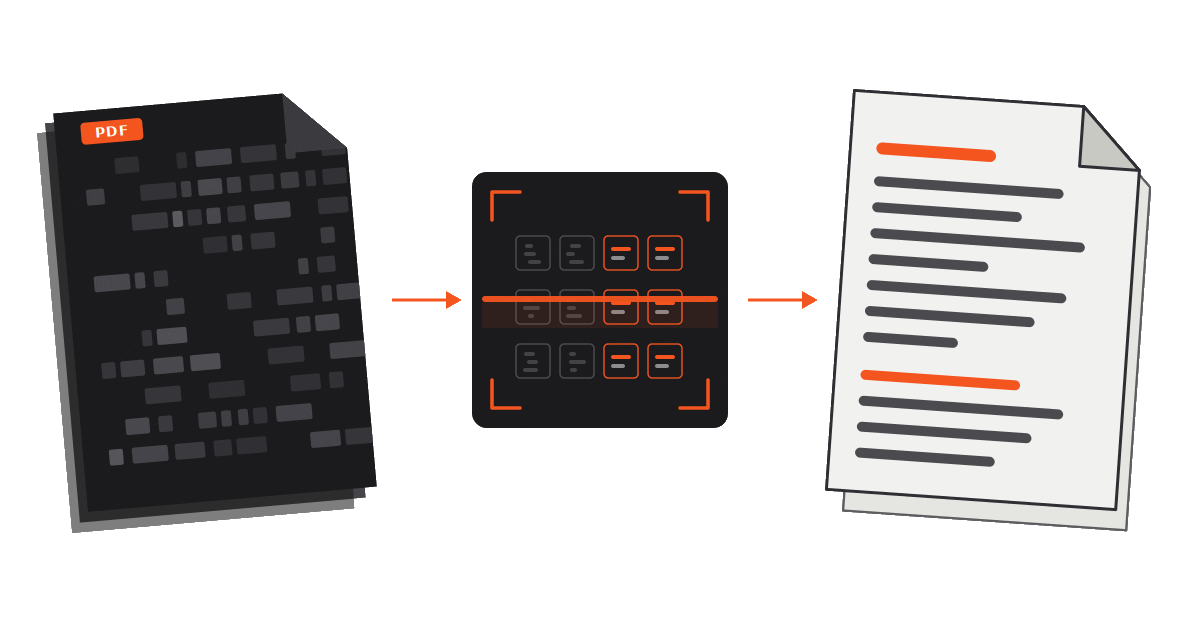
Panoramica sui PDF
- Un PDF descrive come appare una pagina, non cosa significa il documento. Più vicino a una stampa che a un file di documento.
- Alcuni PDF contengono testo reale e rilevabile. Altri sono solo fotografie di pagine, senza alcun testo al loro interno.
- L'OCR è un software usato per «leggere» un PDF, indovinando i caratteri dai pixel. Utile, ma imperfetto.
- Convertire in Word significa ricreare una struttura che non era stata memorizzata, quindi il risultato è una stima.
- Un PDF trasporta dati invisibili: nomi degli autori, percorsi file, annotazioni, bozze precedenti, strati di testo nascosti.
- L'IA costa di più per analizzare i PDF rispetto ad altri formati perché il file deve essere convertito o letto come immagini prima che un modello possa ragionarci.
Un insieme di istruzioni di disegno
I word processor memorizzano la struttura. Un file .docx sa che una certa riga è un Titolo 2, che un blocco di testo è un paragrafo, che una tabella ha quattro colonne e undici righe, e che questa nota appartiene a quella frase. Il software rende la pagina a partire da quella struttura, ed è per questo che lo stesso file scorre in modo sensato su un telefono, con un font diverso o con un formato pagina diverso (ed è così che CamoText riesce a ricreare il formato .docx in un output nuovo e anonimizzato).
Un PDF memorizza invece l'immagine finita. Il suo contenuto è più vicino a un elenco di istruzioni: metti questo glifo a queste coordinate in questo font a questa dimensione; traccia una linea da qui a qui; posiziona questa immagine in questo rettangolo. Il formato è stato progettato da Adobe nei primi anni Novanta per risolvere il problema delle incoerenze di presentazione, creando un formato documento che si visualizza in modo identico ovunque. Ciò è stato ottenuto congelando il layout e scartando gran parte del ragionamento che lo aveva prodotto.
Congelare il layout è il motivo per cui nulla si sposta quando un PDF passa di mano, ma rende anche più difficile l'analisi a valle. In un PDF spesso non esistono un paragrafo, una tabella o un'intestazione; ci sono solo caratteri posti in posizioni che sembrano un paragrafo, una tabella o un'intestazione a un occhio umano.
Due tipi di PDF (e come distinguerli)
PDF con testo rilevabile
Creati in digitale, esportando o stampando in PDF. I caratteri sono davvero nel file. Il software può selezionarli, cercarli, copiarli ed estrarli.
PDF scansionati (immagine)
Immagine creata senza caratteri espliciti: solo pixel disposti in modo che un essere umano li legga come parole.
Prova semplice: aprite il file e provate a selezionare evidenziando una frase, oppure cercate una parola che vedete chiaramente sulla pagina. Se il testo si evidenzia e la ricerca lo trova, il file ha uno strato di testo. Se il cursore disegna solo un rettangolo sulla pagina e la ricerca non restituisce nulla, avete un'immagine.
Esiste un terzo caso, sempre più comune: un documento scansionato già passato da un software di riconoscimento, così che uno strato di testo invisibile si trova sotto l'immagine. Quei file si cercano e si copiano, ma ciò che copiate è l'ipotesi del software sulla pagina, non la pagina stessa. Quella distinzione conta quando ci si affida al testo per qualsiasi cosa, e introduce anche potenziali vettori di esposizione dei dati se l'utente non è consapevole dei due strati.
Cos'è l'OCR e perché è così difficile?
OCR sta per riconoscimento ottico dei caratteri. È un software che esamina l'immagine di una pagina e decide quali caratteri le forme rappresentano con maggiore probabilità. L'OCR moderno è impressionante e, su una scansione pulita, dritta e ad alta risoluzione di testo stampato ordinario in un font comune, è molto accurato.
L'OCR spesso fatica con:
- Qualità della scansione. Bassa risoluzione, fax, fotocopie di fotocopie e foto da telefono scattate di sbieco o con luce irregolare.
- Inclinazione e distorsione. Una pagina scansionata leggermente storta, o fotografata mentre è incurvata in un volume rilegato.
- Segni sulla pagina. Timbri, etichette di exhibit, firme, note manoscritte a margine, ombre di graffette, fori di fustellatura ed evidenziazioni che scurano le lettere sottostanti.
- Grafia. Il riconoscimento del corsivo e del misto stampa resta molto meno affidabile di quello del testo dattiloscritto.
- Tipografia inusuale. Vecchi caratteri da macchina da scrivere, font giuridici condensati, caratteri minuti, cifre tabulari e alfabeti non latini.
- Layout. Il software deve decidere l'ordine in cui leggere ciò che vede. Pagine a due colonne, riquadri laterali, intestazioni, note e tabelle escono di routine intrecciati, così una nota finisce a metà frase o due colonne vengono tessute riga per riga.
- Tabelle. Riconoscere i caratteri in una cella è un problema; capire quale cella appartiene a quale riga e colonna è un problema distinto e più difficile.
Il problema più profondo è che gli errori di solito sono silenziosi. L'OCR non si ferma a segnalare l'incertezza: sostituisce un carattere plausibile e va avanti, così un «1» diventa una «l», un «5» diventa una «S», un punto decimale scompare e un segno negativo viene letto come un trattino. Nulla a schermo indica che la cifra su cui vi basate è cambiata.
Un modello di IA che legge un documento passato dall'OCR eredita ogni errore OCR e non ha modo di sapere che è accaduto. Ragionerà con sicurezza su una data, un importo o il nome di una parte che il software di riconoscimento ha inventato. Verificare le cifre critiche rispetto alla pagina originale è una parte necessaria del flusso di lavoro.
Perché convertire un PDF in Word è così difficile
Il motivo è strutturale: convertire un PDF in un documento Word chiede al software di ricostruire informazioni scartate quando il PDF è stato creato.
Un convertitore deve inferire, dalle sole coordinate nel file:
- Dove iniziano e finiscono parole e paragrafi. Il testo è spesso memorizzato come sequenze sparse di caratteri, a volte lettera per lettera con istruzioni di posizionamento in mezzo. Gli spazi possono non esistere affatto come caratteri; uno «spazio» può essere semplicemente un vuoto di coordinate che il convertitore deve interpretare.
- Quali righe stanno insieme. Un paragrafo è un'ipotesi visiva basata su interlinea e rientro, ed è per questo che i file convertiti spesso si spezzano in dozzine di paragrafi di una sola riga, oppure fondono due paragrafi in uno.
- Che cosa è una tabella. Molte tabelle PDF non hanno un oggetto tabella alle spalle, solo testo disposto a griglia e, a volte, linee tracciate. Il convertitore deve decidere se quelle linee sono bordi, sottolineature o decorazione.
- Che cosa è l'arredo di pagina. Intestazioni correnti, piè di pagina, numeri di pagina, numerazioni Bates, filigrane e timbri di riservatezza sono solo altro testo a coordinate. Finiscono in mezzo al documento a meno che qualcosa non li identifichi e li rimuova.
- Quale font usare. I PDF incorporano sottoinsiemi di font (solo i caratteri effettivamente usati), quindi il font esatto spesso non può essere reinstallato sulla macchina di destinazione. Il convertitore sostituisce qualcosa di simile, e ogni sostituzione sposta gli a capo, il che sposta la paginazione, il che sposta tutto il resto.
- Ordine di lettura. L'ordine in cui i caratteri compaiono nel file non deve coincidere con l'ordine in cui un essere umano li legge. Il testo può essere disegnato in qualsiasi sequenza che il software di produzione abbia trovato conveniente.
Una conversione che azzecca tutto questo su un PDF semplice, a colonna unica e creato in digitale è del tutto plausibile. Una conversione che lo azzecca su un exhibit scansionato con tre colonne, quattro tabelle, note e un timbro in alto è una rarità.
Perché la formattazione è la parte più difficile da conservare
Estrarre le parole è la metà facile. Riprodurre come erano disposte è dove la maggior parte degli strumenti si spezza, perché la formattazione in un PDF è un aspetto, non un'istruzione.
Il grassetto può essere un font davvero in grassetto, oppure lo stesso font disegnato due volte con un leggero offset. Un rientro può essere un'impostazione di paragrafo, oppure semplicemente una coordinata di partenza diversa. Un elenco puntato può essere un elenco, oppure una serie di righe indipendenti ciascuna iniziata da un piccolo cerchio disegnato. Un'intestazione può non portare alcun marcatore di essere un'intestazione oltre a essere più grande e avere più spazio bianco sopra. Un titolo numerato e un paragrafo che capita di iniziare con un numero appaiono identici al software.
Per produrre un documento che imita l'originale, uno strumento deve prima classificare tutto questo correttamente, poi mapparlo su un sistema di formattazione del tutto diverso, con le sue regole su stili, margini e flusso. Gli errori si accumulano: un'intestazione mal identificata cambia il sommario; una tabella mal letta rompe le colonne sotto di essa; una sostituzione di font rifà scorrere la pagina. Ecco perché «conservare la formattazione» è di solito la richiesta più costosa che si possa fare a uno strumento PDF, e perché l'output ha così spesso bisogno di più pulizia di quanto ne avrebbe richiesto una nuova digitazione.
Cos'altro c'è nel file
Un PDF è un contenitore, e un contenitore tiene più della pagina che vedete. Quando il file viene inviato all'esterno, pubblicato o caricato su un servizio di IA, viaggia anche tutto ciò che è al suo interno.
- Metadati ereditati. Esportare da Word di solito porta con sé il nome dell'autore, l'organizzazione e spesso il percorso originale della cartella. Un percorso che nomina il cliente e la pratica è una fuga comune e silenziosa.
- Riquadri neri che non nascondono nulla. Un rettangolo disegnato sopra un nome lo copre visivamente mentre i caratteri restano nel file, recuperabili selezionando la pagina e incollandola altrove.
- Lo strato di testo invisibile. Su un documento scansionato e riconosciuto, il testo riconosciuto sta sotto l'immagine e viaggia con il file che lo sapeste o no.
- Versioni precedenti del documento. I PDF possono essere salvati accodando le modifiche in fondo al file, così gli stati precedenti possono restare all'interno ed essere ricostruiti.
- Annotazioni, commenti, timbri e campi modulo, in genere con il nome e il timestamp di chi li ha aggiunti, inclusi campi che appaiono appiattiti o che non sono mai stati visualizzati.
- Immagini e allegati incorporati, che portano i propri dati. Una fotografia di exhibit può rivelare la fotocamera, la data e le coordinate GPS del luogo dello scatto.
Sfocatura e pixelizzazione sono spesso misure di protezione insufficienti. Dove il valore nascosto è breve e prevedibile (un numero di conto, una data, un codice fiscale), la versione oscurata può spesso essere invertita generando candidati e confrontando. Anche un riquadro davvero opaco lascia un vuoto di larghezza specifica.
Per saperne di più, incluso quanto questo è già costato ad alcune organizzazioni in sanzioni e condanne, vedete Quali informazioni nascoste ci sono nei vostri documenti?
Non potete rivedere ciò che non potete vedere. L'unico modo affidabile per sapere cosa riceve un destinatario (o un servizio di IA) è generare un file nuovo che contenga solo il contenuto che avete messo intenzionalmente.
Perché elaborare i PDF con l'IA costa di più
Gli LLM leggono token, che sono grosso modo frammenti di parole. Costo, velocità e limiti di contesto si misurano tutti in token, e un PDF è un modo costoso di consegnarli.
- Il file deve essere pre-elaborato prima che il modello possa ragionare. Il testo semplice entra dritto nel modello. Un PDF deve essere analizzato, estratto e spesso riparato prima. Quel passaggio avviene nella pipeline dello strumento di IA o nel codice che il modello scrive ed esegue; in entrambi i casi pagate prima che inizi qualsiasi analisi.
- Le pagine scansionate richiedono OCR o, peggio, token di immagine. Se non c'è strato di testo, le pagine vengono riconosciute o consegnate al modello come immagini. Le immagini sono costose: una singola pagina resa come immagine può consumare dell'ordine di un migliaio di token o più, contro poche centinaia per la stessa pagina come testo. Su un exhibit di duecento pagine, la differenza è sostanziale.
- L'arredo di pagina viene fatturato come contenuto. Intestazioni correnti, piè di pagina, numeri di pagina, timbri Bates, legende di riservatezza e blocchi firma si ripetono su ogni pagina e consumano token su ogni pagina, portando quasi nessun valore analitico.
- Anche il rumore OCR consuma token. Caratteri spuri, parole spezzate, colonne intrecciate e simboli mal letti diventano tutti token che il modello deve leggere, e degradano la qualità della risposta.
- I fallimenti provocano tentativi ripetuti. Quando l'estrazione produce qualcosa di incomprensibile, la risposta usuale è provare un metodo diverso, ri-renderizzare le pagine o riformulare la domanda. Ogni tentativo viene fatturato.
- Una struttura cattiva spreca contesto. Un modello che lavora su una tabella mal estratta deve spendere sforzo di ragionamento per ricostruirla, il che allunga la risposta e aumenta la probabilità di errore.
Un documento Word sta nel mezzo: ha testo reale e struttura reale, quindi l'estrazione è economica e affidabile, anche se porta comunque revisioni, commenti e metadati. Il testo semplice pulito o il markdown è l'input più economico e più prevedibile di tutti. Vedete esattamente ciò che vede il modello, e nulla di estraneo viene fatturato o consultato.
Un flusso di lavoro ragionevole per PDF e IA
- Verificate che tipo di PDF avete. Selezionate un po' di testo per vedere se viene rilevato.
- Se ha testo rilevabile, estraetelo. Portate le parole in testo o markdown e leggete cosa è uscito prima di farne qualsiasi altra cosa.
- Se è una scansione, trattate il testo riconosciuto come una bozza. Controllate a campione nomi, date e cifre rispetto alla pagina, in particolare tutto ciò su cui intendete basarvi.
- Rimuovete ciò di cui il compito non ha bisogno. Intestazioni, piè di pagina, numerazioni Bates e arredo di pagina costano token e aggiungono rumore.
- Sostituite gli identificatori prima che il file lasci la vostra macchina, usando segnaposto coerenti così che le relazioni nel documento sopravvivano. Al modello raramente serve sapere chi sono le parti per analizzare ciò su cui hanno convenuto.
- Inviate il testo preparato. Tenete il contenitore PDF originale del tutto fuori dal flusso di lavoro con l'IA.
CamoText legge PDF con testo rilevato (insieme a Word, Excel e altri formati comuni), li elabora in locale sul vostro dispositivo senza connessione a Internet e scrive un output interamente nuovo che contiene solo il contenuto visibile, con identificatori sostituiti da segnaposto coerenti e senza metadati ereditati. Il risultato è un file più leggero, più economico e anonimizzato da consegnare a qualunque strumento di IA usiate, e l'originale non lascia mai il vostro controllo.
Sintesi
Un PDF è l'immagine di una pagina con, a volte, uno strato di testo attaccato. Quel progetto lo rende perfetto per conservare l'aspetto di un documento e scomodo per tutto il resto: il riconoscimento è un'ipotesi, la conversione è una ricostruzione, la formattazione è un aspetto piuttosto che una struttura, e il contenitore trasporta in silenzio dati che la pagina non mostra. Quando un PDF è l'input di un'analisi con IA, tutto questo arriva come costo, rumore ed esposizione.
Ridurre un PDF a testo pulito, rivisto e anonimizzato prima dell'analisi affronta tutti e quattro i problemi in una volta. Per il flusso di lavoro intorno a quel passaggio, vedete Preparare documenti confidenziali per la revisione con IA.