Qu’est-ce qu’un PDF ?
Images scannées, texte détectable, OCR, et pourquoi les PDF coûtent plus cher avec l’IA
8 septembre 2026
Contrats, écritures, relevés, dossiers médicaux, liasses de conseil et classeurs de closing arrivent souvent en PDF, et ils s’affichent de la même façon sur chaque machine qui les ouvre. Cette fiabilité est une raison première de la popularité des PDF.
C’est aussi pourquoi les PDF frustrent presque toutes les tâches autres que les regarder. En convertir un vers Word produit un chaos ; rechercher dans un fichier scanné ne trouve rien ; copier un tableau donne une colonne de charabia ; et en nourrir un outil d’IA coûte plusieurs fois ce que les mêmes mots coûteraient en texte.
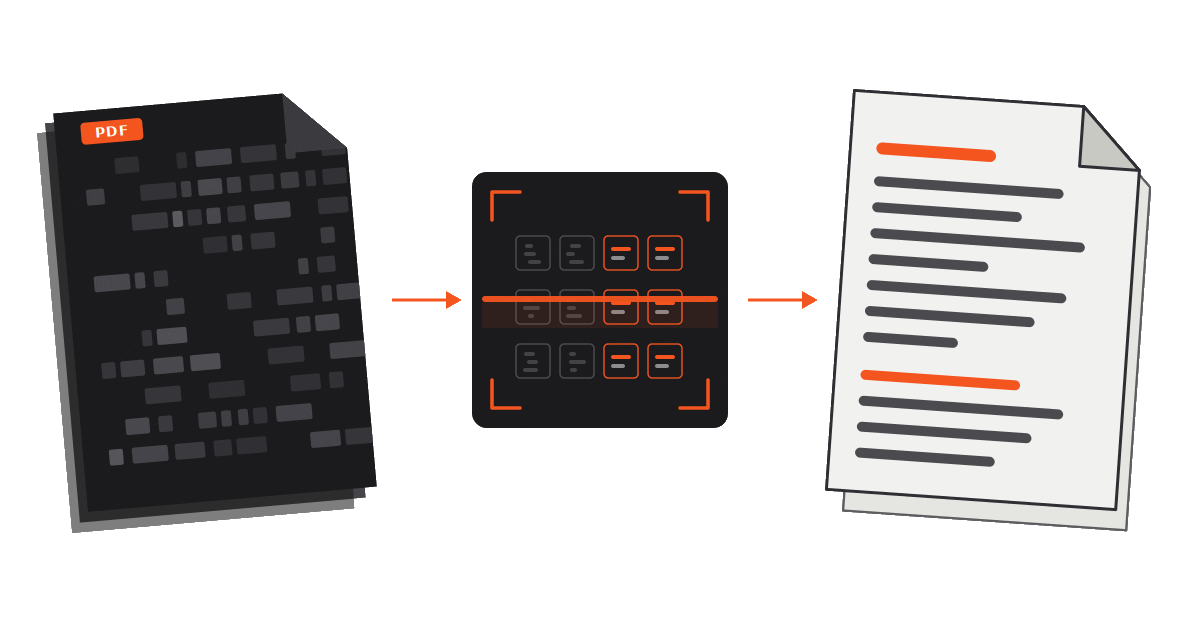
Aperçu du PDF
- Un PDF décrit l’apparence d’une page, pas ce que le document signifie. Plus proche d’une impression que d’un fichier document.
- Certains PDF contiennent du vrai texte détectable. D’autres ne sont que des photographies de pages, sans aucun texte.
- L’OCR est un logiciel utilisé pour « lire » un PDF, en devinant des caractères à partir de pixels. Utile, mais imparfait.
- Convertir vers Word, c’est recréer une structure qui n’était pas stockée, donc le résultat est une estimation.
- Un PDF transporte des données invisibles : noms d’auteurs, chemins de fichiers, annotations, brouillons antérieurs, couches de texte cachées.
- L’IA coûte plus cher à analyser des PDF que d’autres formats, parce que le fichier doit être converti ou lu comme des images avant qu’un modèle puisse raisonner dessus.
Un ensemble d’instructions de peinture
Les traitements de texte stockent une structure. Un fichier .docx sait qu’une ligne particulière est un Titre 2, qu’un bloc de texte est un paragraphe, qu’un tableau a quatre colonnes et onze lignes, et que cette note de bas de page appartient à cette phrase. Le logiciel rend la page à partir de cette structure, ce qui explique pourquoi le même fichier se réagence correctement sur un téléphone, dans une autre police, ou à un autre format de page (et comment CamoText peut recréer le format .docx dans une sortie anonymisée, neuve).
Un PDF stocke plutôt l’image finie. Son contenu se rapproche d’une liste d’instructions : placez ce glyphe à ces coordonnées dans cette police à cette taille ; tracez une ligne d’ici à ici ; placez cette image dans ce rectangle. Le format a été conçu par Adobe au début des années 1990 pour résoudre le problème des incohérences de présentation, en créant un format de document qui s’affiche identiquement partout. Cela a été obtenu en gelant la mise en page et en jetant l’essentiel du raisonnement qui la sous-tendait.
Geler la mise en page explique pourquoi rien ne bouge lorsqu’un PDF change de mains, mais rend aussi plus difficile l’analyse en aval. Dans un PDF, il n’existe souvent ni paragraphe, ni tableau, ni titre ; il n’y a que des caractères posés à des positions qui ressemblent à un paragraphe, un tableau ou un titre pour un œil humain.
Deux sortes de PDF (et comment les distinguer)
PDF avec texte détectable
Créés numériquement, par export ou impression vers PDF. Les caractères sont réellement dans le fichier. Un logiciel peut les sélectionner, les rechercher, les copier et les extraire.
PDF images scannées
Image créée sans caractères explicites : seulement des pixels arrangés pour qu’un humain les lise comme des mots.
Test simple : ouvrez le fichier et essayez de sélectionner une phrase, ou recherchez un mot clairement visible sur la page. Si le texte se surligne et que la recherche le trouve, le fichier a une couche de texte. Si le curseur ne dessine qu’un rectangle sur la page et que la recherche ne donne rien, vous avez une image.
Il existe un troisième cas, de plus en plus fréquent : un document scanné déjà passé par un logiciel de reconnaissance, de sorte qu’une couche de texte invisible se trouve sous l’image. Ces fichiers se recherchent et se copient, mais ce que vous copiez est la devinette du logiciel sur la page, et non la page elle-même. Cette distinction compte dès que l’on s’appuie sur le texte, et introduit aussi des vecteurs d’exposition si l’utilisateur ignore les deux couches.
Qu’est-ce que l’OCR, et pourquoi est-ce si difficile ?
OCR signifie reconnaissance optique de caractères. C’est un logiciel qui examine une image de page et décide quels caractères les formes représentent le plus probablement. L’OCR moderne est impressionnant, et sur un scan propre, droit, haute résolution d’un texte imprimé ordinaire dans une police courante, il est très précis.
L’OCR peine souvent avec :
- La qualité du scan. Faible résolution, télécopies, photocopies de photocopies, et photos de téléphone prises de biais ou sous un éclairage irrégulier.
- L’inclinaison et le gauchissement. Une page scannée légèrement de travers, ou photographiée alors qu’elle est voilée dans un volume relié.
- Les marques sur la page. Tampons, étiquettes de pièces, signatures, notes manuscrites en marge, ombres d’agrafes, perforations, et surlignage qui assombrit les lettres sous-jacentes.
- L’écriture manuscrite. La reconnaissance de la cursive et du mélange manuscrit-imprimé reste bien moins fiable que celle du texte dactylographié.
- La typographie inhabituelle. Anciennes polices de machine à écrire, polices juridiques condensées, petits caractères, chiffres tabulaires, et écritures non latines.
- La mise en page. Le logiciel doit décider de l’ordre de lecture. Les pages à deux colonnes, encadrés, en-têtes, notes de bas de page et tableaux sortent régulièrement entrelacés, si bien qu’une note atterrit au milieu d’une phrase ou que deux colonnes sont tissées ligne par ligne.
- Les tableaux. Reconnaître les caractères d’une cellule est un problème ; déterminer à quelle ligne et quelle colonne appartient chaque cellule en est un autre, plus difficile.
Le problème plus profond est que les erreurs sont généralement silencieuses. L’OCR ne s’arrête pas pour signaler une incertitude : il substitue un caractère plausible et continue, si bien qu’un « 1 » devient un « l », un « 5 » devient un « S », une virgule décimale disparaît, et un signe moins est lu comme un trait d’union. Rien à l’écran n’indique que le chiffre sur lequel vous vous appuyez a changé.
Un modèle d’IA qui lit un document passé à l’OCR hérite de chaque erreur d’OCR et n’a aucun moyen de savoir qu’elle s’est produite. Il raisonnera avec assurance sur une date, un montant ou un nom de partie que le logiciel de reconnaissance a inventé. Vérifier les chiffres critiques par rapport à la page d’origine fait partie nécessaire du flux de travail.
Pourquoi convertir un PDF vers Word est si difficile
La raison est structurelle : convertir un PDF en document Word demande au logiciel de reconstruire des informations qui ont été jetées à la création du PDF.
Un convertisseur doit inférer, à partir des seules coordonnées du fichier :
- Où commencent et finissent les mots et les paragraphes. Le texte est souvent stocké en fragments de caractères dispersés, parfois lettre par lettre avec des instructions de positionnement entre elles. Les espaces peuvent ne pas exister comme caractères du tout ; un « espace » peut n’être qu’un écart de coordonnées que le convertisseur doit interpréter.
- Quelles lignes vont ensemble. Un paragraphe est une estimation visuelle fondée sur l’interligne et le retrait, ce qui explique pourquoi les fichiers convertis se brisent souvent en dizaines de paragraphes d’une ligne, ou fusionnent deux paragraphes en un.
- Ce qu’est un tableau. Beaucoup de tableaux PDF n’ont aucun objet tableau derrière eux, seulement du texte placé en grille et, parfois, des lignes dessinées. Le convertisseur doit décider si ces lignes sont des bordures, des soulignements ou une décoration.
- Ce qu’est le mobilier de page. En-têtes courants, pieds de page, numéros de page, numéros Bates, filigranes et mentions de confidentialité ne sont que davantage de texte à des coordonnées. Ils atterrissent au milieu du document à moins que quelque chose ne les identifie et ne les retire.
- Quelle police utiliser. Les PDF incorporent des sous-ensembles de polices (seulement les caractères réellement utilisés), si bien que la police exacte ne peut souvent pas être réinstallée sur la machine destinataire. Le convertisseur substitue quelque chose de similaire, et chaque substitution décale les sauts de ligne, ce qui décale la pagination, ce qui décale tout le reste.
- L’ordre de lecture. L’ordre d’apparition des caractères dans le fichier n’a pas à correspondre à l’ordre de lecture humain. Le texte peut être peint dans n’importe quelle séquence que le logiciel producteur a trouvée commode.
Une conversion qui réussit tout cela sur un PDF simple, à une colonne, créé numériquement, est tout à fait plausible. Une conversion qui le réussit sur une pièce scannée à trois colonnes, quatre tableaux, notes de bas de page et un tampon en haut de page est une rareté.
Pourquoi la mise en forme est la partie la plus difficile à conserver
Extraire les mots est la moitié facile. Reproduire leur agencement est là où la plupart des outils s’effondrent, parce que la mise en forme dans un PDF est une apparence plutôt qu’une instruction.
Un texte en gras peut être une police réellement grasse, ou la même police dessinée deux fois avec un léger décalage. Un retrait peut être un paramètre de paragraphe, ou simplement une coordonnée de départ différente. Une liste à puces peut être une liste, ou une série de lignes indépendantes commençant chacune par un petit cercle dessiné. Un titre peut ne porter aucun marqueur d’être un titre, au-delà d’être plus grand et d’avoir davantage d’espace blanc au-dessus. Un titre numéroté et un paragraphe qui commence par hasard par un chiffre paraissent identiques au logiciel.
Pour produire un document qui imite l’original, un outil doit d’abord tout classer correctement, puis le mapper sur un système de mise en forme complètement différent, avec ses propres règles de styles, de marges et de flux. Les erreurs s’accumulent : un titre mal identifié change le plan ; un tableau mal lu casse les colonnes en dessous ; une substitution de police réagence la page. C’est pourquoi « conserver la mise en forme » est généralement la demande la plus coûteuse que l’on puisse faire à un outil PDF, et pourquoi la sortie a si souvent besoin de plus de nettoyage que de tout retaper.
Ce qu’il y a d’autre dans le fichier
Un PDF est un conteneur, et un conteneur contient plus que la page que vous voyez. Lorsque le fichier est envoyé à l’extérieur, publié, ou téléversé vers un service d’IA, tout ce qu’il contient voyage aussi.
- Métadonnées héritées. L’export depuis Word emporte généralement le nom de l’auteur, l’organisation, et souvent le chemin de dossier d’origine. Un chemin qui nomme le client et le dossier est une fuite fréquente et discrète.
- Des cadres noirs qui ne cachent rien. Un rectangle dessiné sur un nom le recouvre visuellement tandis que les caractères restent dans le fichier, récupérables en sélectionnant la page et en la collant ailleurs.
- La couche de texte invisible. Sur un document scanné puis reconnu, le texte reconnu se trouve sous l’image et accompagne le fichier, que vous ayez su ou non qu’il était là.
- Des versions antérieures du document. Les PDF peuvent être enregistrés en ajoutant les modifications à la fin du fichier, si bien que des états précédents peuvent rester à l’intérieur et être reconstruits.
- Annotations, commentaires, tampons et champs de formulaire, généralement avec le nom et l’horodatage de la personne qui les a ajoutés, y compris des champs qui paraissent aplatis ou n’ont jamais été affichés.
- Images incorporées et pièces jointes, qui transportent leurs propres données. Une photographie versée au dossier peut divulguer l’appareil, la date et les coordonnées GPS du lieu de prise de vue.
Le flou et la pixellisation sont souvent des mesures de protection insuffisantes. Lorsque la valeur cachée est courte et prévisible (un numéro de compte, une date, un numéro d’identité nationale), la version obscurcie peut souvent être inversée en générant des candidats et en comparant. Même un cadre véritablement opaque laisse un écart d’une largeur précise.
Pour aller plus loin, y compris ce que cela a déjà coûté à certaines organisations en amendes et sanctions, voir Quelles informations cachées se trouvent dans vos documents ?
On ne peut pas relire ce que l’on ne voit pas. Le seul moyen fiable de savoir ce qu’un destinataire (ou un service d’IA) reçoit est de générer un nouveau fichier contenant uniquement le contenu que vous y avez intentionnellement mis.
Pourquoi le traitement IA des PDF coûte plus cher
Les LLM lisent des tokens, qui sont grosso modo des fragments de mots. Le coût, la vitesse et les limites de contexte se mesurent tous en tokens, et un PDF est une façon coûteuse de les livrer.
- Le fichier doit être prétraité avant que le modèle puisse penser. Le texte brut entre directement dans le modèle. Un PDF doit d’abord être analysé, extrait, et souvent réparé. Cette étape a lieu soit dans le pipeline de l’outil d’IA, soit dans du code que le modèle écrit et exécute ; dans les deux cas, vous payez avant que l’analyse ne commence.
- Les pages scannées exigent de l’OCR, ou pire, des tokens d’image. S’il n’y a pas de couche de texte, les pages sont reconnues, ou remises au modèle sous forme d’images. Les images sont chères : une seule page rendue en image peut consommer de l’ordre d’un millier de tokens ou plus, contre quelques centaines pour la même page en texte. Sur une pièce de deux cents pages, la différence est substantielle.
- Le mobilier de page est facturé comme du contenu. En-têtes courants, pieds de page, numéros de page, tampons Bates, légendes de confidentialité et blocs de signature se répètent à chaque page et consomment des tokens à chaque page tout en n’apportant presque aucune valeur analytique.
- Le bruit d’OCR consomme aussi des tokens. Caractères parasites, mots cassés, colonnes entrelacées et symboles mal lus deviennent tous des tokens que le modèle doit lire, et ils dégradent la qualité de la réponse.
- Les échecs provoquent des nouvelles tentatives. Lorsque l’extraction produit quelque chose de brouillé, la réaction habituelle est d’essayer une autre méthode, de re-rendre les pages, ou de reposer la question. Chaque tentative est facturée.
- Une mauvaise structure gaspille le contexte. Un modèle qui travaille avec un tableau mal extrait doit dépenser de l’effort de raisonnement pour le reconstruire, ce qui allonge la réponse et augmente le risque d’erreur.
Un document Word se situe au milieu : il a du vrai texte et une vraie structure, donc l’extraction est bon marché et fiable, bien qu’il emporte encore le suivi des modifications, les commentaires et les métadonnées. Le texte brut propre ou le markdown est l’entrée la moins chère et la plus prévisible. Vous voyez précisément ce que le modèle voit, et rien de superflu n’est facturé ni consulté.
Un flux de travail raisonnable pour les PDF et l’IA
- Vérifiez de quel type de PDF vous disposez. Sélectionnez du texte pour voir s’il est détecté.
- S’il a du texte détectable, extrayez-le. Sortez les mots en texte ou en markdown et lisez ce qui en est sorti avant de faire quoi que ce soit d’autre.
- S’il s’agit d’un scan, traitez le texte reconnu comme un brouillon. Contrôlez par sondage les noms, dates et chiffres par rapport à la page, surtout tout ce sur quoi vous entendez vous appuyer.
- Retirez ce dont la tâche n’a pas besoin. En-têtes, pieds de page, numéros Bates et mobilier de page coûtent des tokens et ajoutent du bruit.
- Remplacez les identifiants avant que le fichier ne quitte votre machine, avec des espaces réservés cohérents pour que les relations à travers le document survivent. Le modèle a rarement besoin de savoir qui sont les parties pour analyser ce qu’elles ont convenu.
- Envoyez le texte préparé. Gardez le conteneur PDF d’origine entièrement hors du flux d’IA.
CamoText lit les PDF à texte détecté (ainsi que Word, Excel et d’autres formats courants), les traite localement sur votre propre appareil sans connexion Internet, et écrit une sortie entièrement nouvelle contenant uniquement le contenu visible, avec des identifiants remplacés par des espaces réservés cohérents et sans métadonnées héritées. Le résultat est un fichier plus léger, moins cher, anonymisé, à remettre à l’outil d’IA de votre choix, et l’original ne quitte jamais votre contrôle.
Synthèse
Un PDF est une image de page avec, parfois, une couche de texte attachée. Cette conception le rend parfait pour préserver l’apparence d’un document et maladroit pour tout le reste : la reconnaissance est une estimation, la conversion est une reconstruction, la mise en forme est une apparence plutôt qu’une structure, et le conteneur transporte silencieusement des données que la page n’affiche pas. Lorsqu’un PDF est l’entrée d’une analyse IA, tout cela arrive sous forme de coût, de bruit et d’exposition.
Réduire un PDF à du texte propre, relu et anonymisé avant l’analyse traite ces quatre problèmes à la fois. Pour le flux de travail autour de cette étape, voir Préparer des documents confidentiels pour une revue par IA.