¿Qué es un PDF?
Imágenes escaneadas, texto detectable, OCR y por qué los PDF cuestan más al usarlos con IA
8 de septiembre de 2026
Contratos, escritos, extractos, historiales médicos, carpetas de consejo y binders de cierre suelen llegar como PDF, y se ven idénticos en cualquier máquina que los abra. Esa fiabilidad es una de las razones principales de su popularidad.
También es por eso que los PDF frustran casi cualquier tarea que no sea mirarlos. Convertir uno a Word produce un desastre; buscar en un archivo escaneado no encuentra nada; copiar una tabla da una columna de sinsentido; y enviarlo a una herramienta de IA cuesta varias veces lo que costarían las mismas palabras como texto.
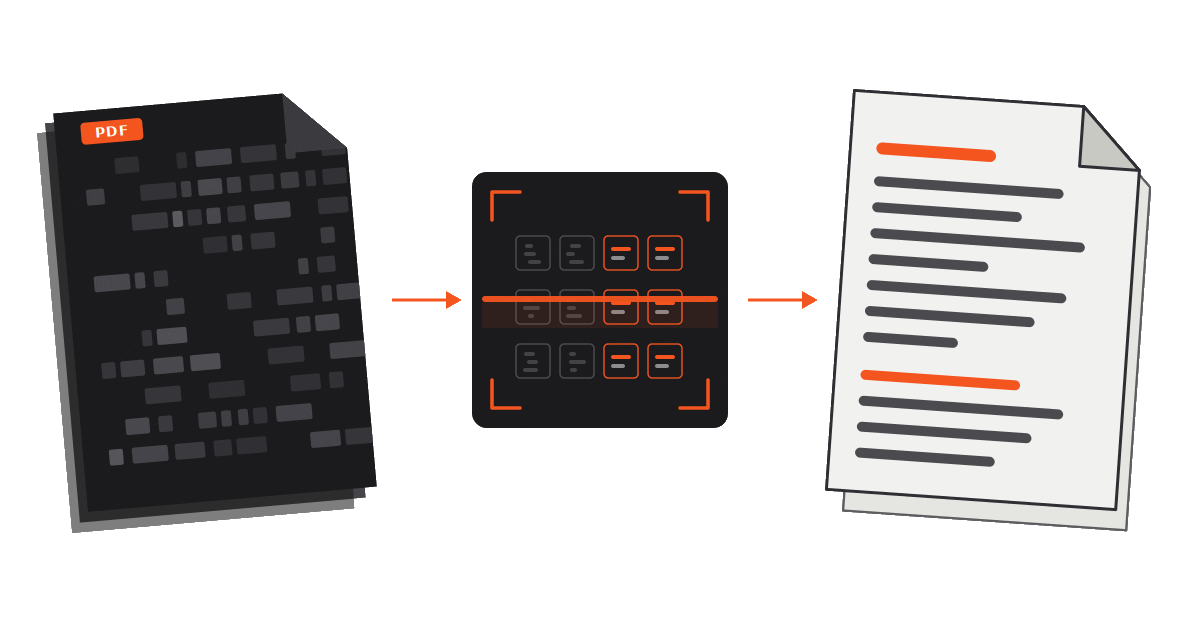
Panorama del PDF
- Un PDF describe cómo se ve una página, no qué significa el documento. Más cercano a una impresión que a un archivo de documento.
- Algunos PDF contienen texto real y detectable. Otros son solo fotografías de páginas sin texto alguno.
- El OCR es software que «lee» un PDF, conjeturando caracteres a partir de píxeles. Útil, pero imperfecto.
- Convertir a Word significa recrear una estructura que no se almacenó, así que el resultado es una estimación.
- Un PDF transporta datos invisibles: nombres de autor, rutas de archivo, anotaciones, borradores anteriores, capas de texto ocultas.
- La IA cuesta más al analizar PDF que otros formatos porque el archivo tiene que convertirse o leerse como imágenes antes de que un modelo pueda razonar sobre él.
Un conjunto de instrucciones de pintura
Los procesadores de texto almacenan estructura. Un archivo .docx sabe que una línea concreta es un Encabezado 2, que un bloque de texto es un párrafo, que una tabla tiene cuatro columnas y once filas, y que esta nota al pie pertenece a esa frase. El software dibuja la página a partir de esa estructura, por eso el mismo archivo se reajusta con sentido en un teléfono, con otra fuente o con otro tamaño de página (y por eso CamoText puede recrear el formato .docx en una salida nueva y anonimizada).
Un PDF almacena en cambio la imagen terminada. Su contenido se parece más a una lista de instrucciones: ponga este glifo en estas coordenadas, con esta fuente y este tamaño; dibuje una línea de aquí a aquí; coloque esta imagen en este rectángulo. Adobe diseñó el formato a principios de los años noventa para resolver las inconsistencias de presentación, creando un formato de documento que se muestra idéntico en todas partes. Lo consiguió congelando el diseño y descartando la mayor parte del razonamiento que lo sustentaba.
Congelar el diseño es por qué nada se mueve cuando un PDF cambia de manos, pero también hace más difícil el análisis posterior. En un PDF a menudo no existe un párrafo, una tabla o un encabezado; solo hay caracteres sentados en posiciones que parecen un párrafo, una tabla o un encabezado a un ojo humano.
Dos tipos de PDF (y cómo distinguirlos)
PDF con texto detectable
Creados de forma digital, al exportar o imprimir a PDF. Los caracteres están realmente en el archivo. El software puede seleccionarlos, buscarlos, copiarlos y extraerlos.
PDF de imagen escaneada
Imagen creada sin caracteres explícitos: solo píxeles dispuestos de modo que un ser humano los lee como palabras.
Prueba sencilla: abra el archivo e intente seleccionar una frase, o busque una palabra que vea claramente en la página. Si el texto se resalta y la búsqueda lo encuentra, el archivo tiene una capa de texto. Si el cursor solo dibuja un rectángulo sobre la página y la búsqueda no da resultado, tiene una imagen.
Hay un tercer caso cada vez más habitual: un documento escaneado que ya ha pasado por software de reconocimiento, de modo que una capa de texto invisible queda bajo la imagen. Esos archivos se pueden buscar y copiar, pero lo que se copia es la conjetura del software sobre la página, no la página misma. Esa distinción importa en cuanto se confía en el texto para cualquier cosa, y también introduce posibles vectores de exposición de datos si el usuario no es consciente de las dos capas.
¿Qué es el OCR y por qué es tan difícil?
OCR significa reconocimiento óptico de caracteres. Es software que examina una imagen de una página y decide qué caracteres representan con más probabilidad esas formas. El OCR moderno es impresionante y, en un escaneo limpio, recto y de alta resolución de texto impreso ordinario en una fuente habitual, es muy preciso.
El OCR suele fallar con:
- Calidad del escaneo. Baja resolución, faxes, fotocopias de fotocopias y fotos de teléfono tomadas en ángulo o con luz irregular.
- Sesgo y deformación. Una página escaneada un poco torcida, o fotografiada mientras está curvada en un volumen encuadernado.
- Marcas en la página. Sellos, etiquetas de prueba, firmas, notas manuscritas al margen, sombras de grapas, perforaciones y resaltados que oscurecen las letras de debajo.
- Escritura a mano. El reconocimiento de cursiva y de letra mixta sigue siendo mucho menos fiable que el del texto mecanografiado.
- Tipografía poco habitual. Caras de máquina de escribir antiguas, fuentes jurídicas condensadas, letra pequeña, números tabulares y alfabetos no latinos.
- Diseño. El software debe decidir en qué orden leer lo que ve. Las páginas a dos columnas, los recuadros laterales, los encabezados, las notas al pie y las tablas salen a menudo intercalados, de modo que una nota al pie cae a mitad de frase o dos columnas se tejen línea a línea.
- Tablas. Reconocer los caracteres de una celda es un problema; averiguar qué celda pertenece a qué fila y columna es otro, más difícil.
El problema de fondo es que los errores suelen ser silenciosos. El OCR no se detiene ni señala la incertidumbre: sustituye un carácter plausible y sigue, de modo que un «1» se convierte en una «l», un «5» en una «S», desaparece un punto decimal y un signo negativo se lee como un guion. Nada en pantalla indica que la cifra en la que se apoya ha cambiado.
Un modelo de IA que lee un documento pasado por OCR hereda cada error de OCR y no tiene forma de saber que ocurrió. Razonará con seguridad sobre una fecha, un importe o un nombre de parte que el software de reconocimiento inventó. Verificar las cifras críticas contra la página original es una parte necesaria del flujo de trabajo.
Por qué convertir un PDF a Word es tan difícil
La razón es estructural: convertir un PDF a un documento de Word pide al software reconstruir información que se tiró cuando se creó el PDF.
Un conversor tiene que inferir, solo a partir de las coordenadas del archivo:
- Dónde empiezan y terminan las palabras y los párrafos. El texto se almacena a menudo como fragmentos dispersos de caracteres, a veces letra a letra con instrucciones de posición entremedias. Los espacios pueden no existir como caracteres; un «espacio» puede ser simplemente un hueco en las coordenadas que el conversor debe interpretar.
- Qué líneas van juntas. Un párrafo es una conjetura visual basada en el interlineado y la sangría, por eso los archivos convertidos a menudo se rompen en docenas de párrafos de una sola línea, o fusionan dos párrafos en uno.
- Qué es una tabla. Muchas tablas de PDF no tienen un objeto tabla detrás, solo texto colocado en una cuadrícula y, a veces, líneas dibujadas. El conversor tiene que decidir si esas líneas son bordes, subrayados o decoración.
- Qué es mobiliario de página. Encabezados y pies repetidos, números de página, números Bates, marcas de agua y sellos de confidencialidad son solo más texto en coordenadas. Caen en medio del documento a menos que algo los identifique y los quite.
- Qué fuente usar. Los PDF incrustan subconjuntos de fuentes (solo los caracteres realmente usados), así que la fuente exacta a menudo no se puede reinstalar en la máquina receptora. El conversor sustituye algo similar, y cada sustitución desplaza los saltos de línea, lo que desplaza la paginación, lo que desplaza todo lo demás.
- Orden de lectura. El orden en que aparecen los caracteres en el archivo no tiene por qué coincidir con el orden en que un humano los lee. El texto puede pintarse en cualquier secuencia que resultara cómoda al software productor.
Una conversión que acierte todo esto en un PDF sencillo, de una sola columna y creado de forma digital, es del todo plausible. Una conversión que acierte en una prueba escaneada con tres columnas, cuatro tablas, notas al pie y un sello en la parte superior es una rareza.
Por qué el formato es lo más difícil de preservar
Extraer las palabras es la mitad fácil. Reproducir cómo estaban dispuestas es donde la mayoría de las herramientas se vienen abajo, porque el formato en un PDF es una apariencia, no una instrucción.
El texto en negrita puede ser una fuente realmente negrita, o la misma fuente dibujada dos veces con un ligero desplazamiento. Una sangría puede ser un ajuste de párrafo, o simplemente una coordenada de inicio distinta. Una lista con viñetas puede ser una lista, o una serie de líneas independientes que empiezan cada una con un pequeño círculo dibujado. Un encabezado puede no llevar ninguna marca de ser encabezado más allá de ser más grande y tener más espacio en blanco encima. Un encabezado numerado y un párrafo que casualmente empieza con un número se ven idénticos para el software.
Para producir un documento que imite el original, una herramienta tiene que clasificar todo esto correctamente y luego mapearlo a un sistema de formato completamente distinto, con sus propias reglas sobre estilos, márgenes y flujo. Los errores se acumulan: un encabezado mal identificado cambia el esquema; una tabla mal leída rompe las columnas de debajo; una sustitución de fuente reajusta la página. Por eso «mantener el formato» suele ser la petición más cara que se puede hacer a una herramienta de PDF, y por eso la salida a menudo exige más limpieza de la que habría costado volver a escribirlo.
Qué más hay dentro del archivo
Un PDF es un contenedor, y un contenedor guarda más que la página que se ve. Cuando el archivo se envía fuera, se publica o se sube a un servicio de IA, todo lo que hay dentro viaja también.
- Metadatos heredados. Exportar desde Word suele arrastrar el nombre del autor, la organización y a menudo la ruta original de la carpeta. Una ruta que nombra al cliente y al asunto es una filtración habitual y discreta.
- Recuadros negros que no ocultan nada. Un rectángulo dibujado sobre un nombre lo cubre visualmente mientras los caracteres siguen en el archivo, recuperables al seleccionar la página y pegarla en otro sitio.
- La capa de texto invisible. En un documento escaneado y reconocido, el texto reconocido queda bajo la imagen y viaja con el archivo tanto si se sabía que estaba ahí como si no.
- Versiones anteriores del documento. Los PDF pueden guardarse añadiendo los cambios al final del archivo, de modo que estados previos pueden quedar dentro y reconstruirse.
- Anotaciones, comentarios, sellos y campos de formulario, por lo general con el nombre y la marca de tiempo de quien los añadió, incluidos campos que parecen aplanados o que nunca se mostraron.
- Imágenes incrustadas y archivos adjuntos, que arrastran sus propios datos. Una fotografía de prueba puede revelar la cámara, la fecha y las coordenadas GPS de donde se tomó.
El desenfoque y el pixelado suelen ser medidas de protección insuficientes. Cuando el valor oculto es corto y predecible (un número de cuenta, una fecha, un documento de identidad), la versión oscurecida a menudo puede revertirse generando candidatos y comparando. Incluso un recuadro realmente opaco deja un hueco de una anchura concreta.
Para más información, incluido lo que esto ha costado a algunas organizaciones en multas y sanciones, vea ¿Qué información oculta hay en sus documentos?
No se puede revisar lo que no se ve. La única forma fiable de saber qué recibe un destinatario (o un servicio de IA) es generar un archivo nuevo que contenga solo el contenido que se puso en él a propósito.
Por qué el procesamiento con IA de PDF cuesta más
Los LLM leen tokens, que son, grosso modo, fragmentos de palabras. El coste, la velocidad y los límites de contexto se miden todos en tokens, y un PDF es una forma cara de entregarlos.
- El archivo tiene que preprocesarse antes de que el modelo pueda pensar. El texto plano entra directo en el modelo. Un PDF hay que analizarlo, extraerlo y a menudo repararlo primero. Ese paso ocurre en la propia tubería de la herramienta de IA o en código que el modelo escribe y ejecuta; de un modo u otro se paga antes de que empiece el análisis.
- Las páginas escaneadas exigen OCR o, peor, tokens de imagen. Si no hay capa de texto, las páginas se reconocen o se entregan al modelo como imágenes. Las imágenes son caras: una sola página renderizada como imagen puede consumir del orden de mil tokens o más, frente a unos pocos cientos por la misma página como texto. En una prueba de doscientas páginas, la diferencia es sustancial.
- El mobiliario de página se factura como contenido. Encabezados y pies repetidos, números de página, sellos Bates, leyendas de confidencialidad y bloques de firma se repiten en cada página y consumen tokens en cada página, aportando casi ningún valor analítico.
- El ruido del OCR también consume tokens. Caracteres sueltos, palabras rotas, columnas intercaladas y símbolos mal leídos se convierten todos en tokens que el modelo debe leer, y degradan la calidad de la respuesta.
- Los fallos provocan reintentos. Cuando la extracción produce algo ininteligible, la respuesta habitual es probar otro método, volver a renderizar las páginas o repetir la pregunta. Cada intento se factura.
- Una mala estructura desperdicia contexto. Un modelo que trabaja con una tabla mal extraída tiene que gastar esfuerzo de razonamiento en reconstruirla, lo que alarga la respuesta y aumenta la probabilidad de error.
Un documento de Word se sitúa en el medio: tiene texto real y estructura real, así que la extracción es barata y fiable, aunque sigue arrastrando control de cambios, comentarios y metadatos. El texto plano limpio o markdown es la entrada más barata y predecible de todas. Se ve exactamente lo que ve el modelo, y nada superfluo se factura ni se accede.
Un flujo de trabajo razonable para PDF e IA
- Compruebe qué tipo de PDF tiene. Seleccione algo de texto para ver si se detecta.
- Si tiene texto detectable, extráigalo. Saque las palabras a texto o markdown y lea lo que salió antes de hacer nada más con ello.
- Si es un escaneo, trate el texto reconocido como un borrador. Compruebe al azar nombres, fechas y cifras contra la página, en especial cualquier cosa en la que pretenda apoyarse.
- Quite lo que la tarea no necesita. Encabezados, pies, números Bates y mobiliario de página cuestan tokens y añaden ruido.
- Sustituya los identificadores antes de que el archivo salga de su máquina, usando marcadores de posición coherentes para que las relaciones a lo largo del documento sobrevivan. El modelo rara vez necesita saber quiénes son las partes para analizar lo que acordaron.
- Envíe el texto preparado. Deje el contenedor PDF original fuera del flujo de trabajo de IA por completo.
CamoText lee PDF con texto detectado (junto con Word, Excel y otros formatos habituales), los procesa en local en su propio dispositivo sin conexión a internet y escribe una salida enteramente nueva que contiene solo el contenido visible, con identificadores sustituidos por marcadores de posición coherentes y sin metadatos heredados. El resultado es un archivo más ligero, más barato y anonimizado para entregar a la herramienta de IA que use, y el original nunca sale de su control.
Resumen
Un PDF es una imagen de una página con, a veces, una capa de texto adjunta. Ese diseño lo hace perfecto para preservar cómo se ve un documento y torpe para todo lo demás: el reconocimiento es una conjetura, la conversión es una reconstrucción, el formato es una apariencia más que una estructura, y el contenedor transporta en silencio datos que la página no muestra. Cuando un PDF es la entrada al análisis con IA, todo eso llega como coste, ruido y exposición.
Reducir un PDF a texto limpio, revisado y anonimizado antes del análisis aborda los cuatro problemas a la vez. Para el flujo de trabajo en torno a ese paso, vea Preparar Documentos Confidenciales para Revisión con IA.