Was ist ein PDF?
Gescannte Bilder, erkennbare Textschicht, OCR und warum PDFs mit KI teurer sind
8. September 2026
Verträge, Schriftsätze, Kontoauszüge, Krankenakten, Vorstandsunterlagen und Abschlussordner kommen oft als PDF und sehen auf jedem Rechner, der sie öffnet, identisch aus. Diese Zuverlässigkeit ist ein Hauptgrund für die Beliebtheit von PDFs.
Sie ist auch der Grund, warum PDFs fast jede Aufgabe außer dem Betrachten erschweren. Die Umwandlung nach Word erzeugt ein Chaos; die Suche in einer gescannten Datei findet nichts; das Kopieren einer Tabelle ergibt eine Spalte voller Kauderwelsch; und das Einspeisen in ein KI-Tool kostet ein Vielfaches dessen, was dieselben Wörter als Text kosten würden.
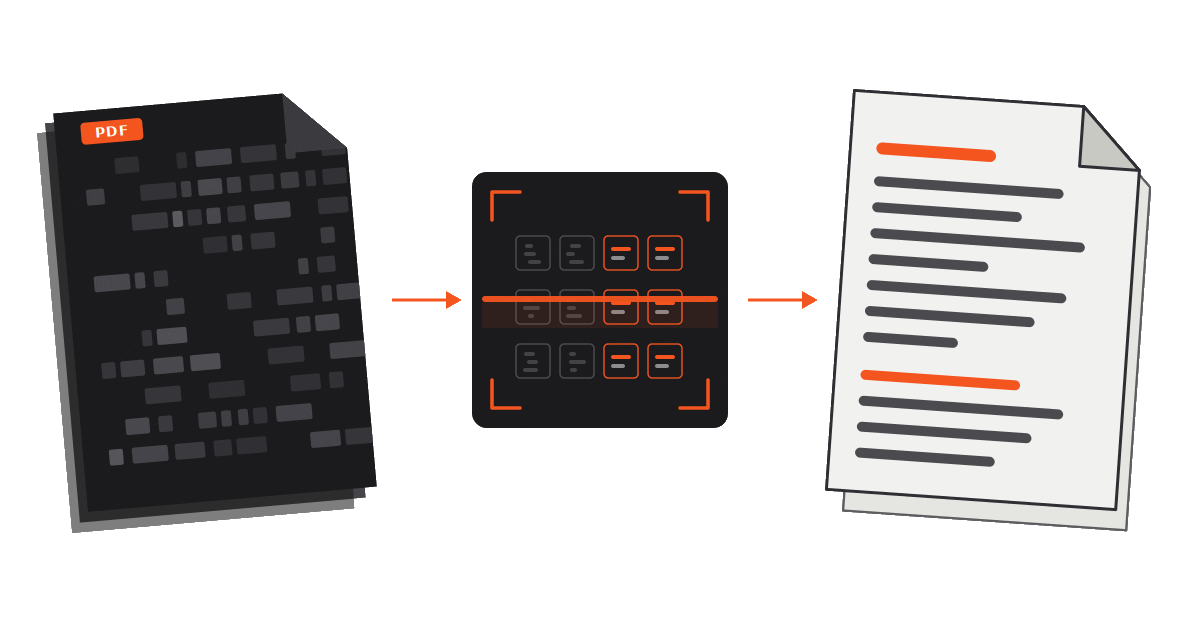
PDF im Überblick
- Ein PDF beschreibt wie eine Seite aussieht, nicht was das Dokument bedeutet. Näher an einem Ausdruck als an einer Dokumentdatei.
- Manche PDFs enthalten echten, erkennbaren Text. Andere sind nur Fotos von Seiten ohne jeglichen Text darin.
- OCR ist Software, die ein PDF „liest“ und Zeichen aus Pixeln rät. Nützlich, aber unvollkommen.
- Die Umwandlung nach Word bedeutet, Struktur neu zu erzeugen, die nicht gespeichert war; das Ergebnis ist daher eine Schätzung.
- Ein PDF trägt unsichtbare Daten: Autorennamen, Dateipfade, Anmerkungen, frühere Entwürfe, versteckte Textschichten.
- KI kostet bei der Analyse von PDFs mehr als bei anderen Formaten, weil die Datei erst umgewandelt oder als Bilder gelesen werden muss, bevor ein Modell darüber nachdenken kann.
Eine Anweisungsliste zum Zeichnen
Textverarbeitungsprogramme speichern Struktur. Eine .docx-Datei weiß, dass eine bestimmte Zeile eine Überschrift 2 ist, dass ein Textblock ein Absatz ist, dass eine Tabelle vier Spalten und elf Zeilen hat und dass diese Fußnote zu jenem Satz gehört. Die Software rendert die Seite aus dieser Struktur, weshalb dieselbe Datei auf einem Telefon, in einer anderen Schrift oder bei einem anderen Seitenformat sinnvoll umbricht (und wie CamoText das .docx-Format in anonymisierter, neuer Ausgabe nachbilden kann).
Ein PDF speichert stattdessen das fertige Bild. Sein Inhalt ähnelt einer Anweisungsliste: setze dieses Zeichen an diese Koordinaten in dieser Schrift in dieser Größe; ziehe eine Linie von hier nach hier; platziere dieses Bild in diesem Rechteck. Das Format wurde Anfang der 1990er Jahre von Adobe entworfen, um Inkonsistenzen in der Darstellung zu lösen, indem ein Dokumentformat geschaffen wurde, das überall identisch erscheint. Das gelang, indem das Layout eingefroren und der größte Teil der dahinterliegenden Logik verworfen wurde.
Das Einfrieren des Layouts ist der Grund, warum sich nichts verschiebt, wenn ein PDF den Besitzer wechselt — und warum die Weiterverarbeitung schwieriger wird. In einem PDF gibt es oft weder Absatz noch Tabelle noch Überschrift; es gibt nur Zeichen an Positionen, die für das menschliche Auge wie ein Absatz, eine Tabelle oder eine Überschrift aussehen.
Zwei Arten von PDFs (und wie man sie unterscheidet)
PDFs mit erkennbarer Textschicht
Digital erzeugt, durch Export oder Drucken nach PDF. Die Zeichen sind wirklich in der Datei. Software kann sie markieren, durchsuchen, kopieren und extrahieren.
Gescannte Bild-PDFs
Bild ohne explizite Zeichen: nur Pixel, so angeordnet, dass ein Mensch sie als Wörter liest.
Einfacher Test: öffnen Sie die Datei und versuchen Sie, einen Satz zu markieren, oder suchen Sie nach einem Wort, das Sie deutlich auf der Seite sehen. Wenn der Text markiert wird und die Suche ihn findet, hat die Datei eine Textschicht. Wenn der Cursor nur ein Rechteck über die Seite zieht und die Suche leer ausgeht, haben Sie ein Bild.
Es gibt einen dritten, zunehmend häufigen Fall: ein gescanntes Dokument, das bereits durch Erkennungssoftware gelaufen ist, sodass eine unsichtbare Textschicht unter dem Bild liegt. Diese Dateien lassen sich durchsuchen und kopieren, aber das, was Sie kopieren, ist die Vermutung der Software zur Seite, nicht die Seite selbst. Dieser Unterschied zählt, sobald der Text für irgendetwas herangezogen wird, und eröffnet zudem mögliche Datenexpositionswege, wenn jemand die zwei Schichten nicht kennt.
Was ist OCR, und warum ist es so schwierig?
OCR steht für Optical Character Recognition, optische Zeichenerkennung. Es ist Software, die ein Bild einer Seite untersucht und entscheidet, welche Zeichen die Formen am ehesten darstellen. Moderne OCR ist beeindruckend, und bei einem sauberen, geraden, hochauflösenden Scan gewöhnlichen gedruckten Texts in einer gängigen Schrift ist sie sehr genau.
OCR hat oft Schwierigkeiten mit:
- Scanqualität. Niedrige Auflösung, Faxe, Kopien von Kopien und Handyfotos, die schräg oder bei ungleichmäßigem Licht aufgenommen wurden.
- Schräglage und Verzerrung. Eine leicht schief gescannte Seite oder ein Foto einer gewölbten Seite in einem gebundenen Band.
- Markierungen auf der Seite. Stempel, Beweisaufkleber, Unterschriften, handschriftliche Randnotizen, Heftklammerschatten, Locher und Markierungen, die die darunterliegenden Buchstaben verdunkeln.
- Handschrift. Die Erkennung von Kursivschrift und gemischtem Druck bleibt weit weniger zuverlässig als die Erkennung von Maschinenschrift.
- Ungewöhnliche Typografie. Alte Schreibmaschinenschriften, verdichtete juristische Schriften, Kleindruck, Tabellenziffern und nicht-lateinische Schriftsysteme.
- Layout. Die Software muss entscheiden, in welcher Reihenfolge sie liest, was sie sieht. Zweispaltenseiten, Seitenleisten, Kopfzeilen, Fußnoten und Tabellen kommen regelmäßig ineinander verwoben heraus, sodass eine Fußnote mitten im Satz landet oder zwei Spalten Zeile für Zeile verflochten werden.
- Tabellen. Die Zeichen in einer Zelle zu erkennen ist ein Problem; zu klären, welche Zelle zu welcher Zeile und Spalte gehört, ist ein anderes und schwierigeres.
Das tiefere Problem ist, dass die Fehler in der Regel still bleiben. OCR hält nicht an und kennzeichnet Unsicherheit: sie setzt ein plausibles Zeichen ein und macht weiter, sodass aus einer „1“ ein „l“ wird, aus einer „5“ ein „S“, ein Dezimalpunkt verschwindet und ein Minuszeichen als Bindestrich gelesen wird. Nichts auf dem Bildschirm zeigt an, dass sich die Zahl, auf die Sie sich stützen, verändert hat.
Ein KI-Modell, das ein OCR-Dokument liest, erbt jeden OCR-Fehler und hat keine Möglichkeit zu wissen, dass er passiert ist. Es wird selbstbewusst über ein Datum, einen Geldbetrag oder einen Parteinamen nachdenken, den die Erkennungssoftware erfunden hat. Kritische Zahlen gegen die Originalseite zu prüfen ist ein notwendiger Bestandteil des Workflows.
Warum die Umwandlung eines PDFs nach Word so schwierig ist
Der Grund ist strukturell: ein PDF in ein Word-Dokument umzuwandeln verlangt von Software, Informationen zu rekonstruieren, die bei der PDF-Erstellung verworfen wurden.
Ein Konverter muss allein aus den Koordinaten in der Datei ableiten:
- Wo Wörter und Absätze beginnen und enden. Text wird häufig als verstreute Zeichenläufe gespeichert, manchmal Buchstabe für Buchstabe mit Positionsanweisungen dazwischen. Leerzeichen existieren oft gar nicht als Zeichen; ein „Leerzeichen“ kann einfach eine Lücke in den Koordinaten sein, die der Konverter interpretieren muss.
- Welche Zeilen zusammengehören. Ein Absatz ist eine visuelle Vermutung auf Basis von Zeilenabstand und Einrückung, weshalb umgewandelte Dateien oft in Dutzende einzeilige Absätze zerfallen oder zwei Absätze zu einem zusammenlaufen.
- Was eine Tabelle ist. Viele PDF-Tabellen haben kein Tabellenobjekt dahinter, nur Text im Raster und manchmal gezeichnete Linien. Der Konverter muss entscheiden, ob diese Linien Rahmen, Unterstreichungen oder Dekoration sind.
- Was Seitenelemente sind. Laufende Kopf- und Fußzeilen, Seitenzahlen, Bates-Nummern, Wasserzeichen und Vertraulichkeitsstempel sind nur weiterer Text an Koordinaten. Sie landen mitten im Dokument, sofern sie nicht erkannt und entfernt werden.
- Welche Schrift zu verwenden ist. PDFs betten Schriftuntermengen ein (nur die tatsächlich verwendeten Zeichen), sodass die genaue Schrift auf dem Empfangsrechner oft nicht neu installiert werden kann. Der Konverter ersetzt etwas Ähnliches, und jede Ersetzung verschiebt Zeilenumbrüche, damit die Paginierung und damit alles andere.
- Lesereihenfolge. Die Reihenfolge, in der Zeichen in der Datei erscheinen, muss nicht der Reihenfolge entsprechen, in der ein Mensch sie liest. Text kann in jeder Sequenz gezeichnet werden, die der erzeugenden Software gelegen kam.
Eine Umwandlung, die das alles bei einem einfachen, einspaltigen, digital erzeugten PDF richtig macht, ist durchaus plausibel. Eine Umwandlung, die das bei einem gescannten Beweisstück mit drei Spalten, vier Tabellen, Fußnoten und einem Stempel oben schafft, ist eine Seltenheit.
Warum Formatierung der schwierigste Teil der Bewahrung ist
Die Wörter zu extrahieren ist die leichte Hälfte. Wiederzugeben, wie sie angeordnet waren, ist der Punkt, an dem die meisten Werkzeuge scheitern, weil Formatierung in einem PDF ein Erscheinungsbild ist, keine Anweisung.
Fettdruck kann eine wirklich fette Schrift sein oder dieselbe Schrift zweimal mit leichter Versetzung. Eine Einrückung kann eine Absatzeinstellung sein oder einfach eine andere Startkoordinate. Eine Aufzählung kann eine Liste sein oder eine Reihe unabhängiger Zeilen, die jeweils mit einem kleinen gezeichneten Kreis beginnen. Eine Überschrift mag kein anderes Merkmal tragen, als größer zu sein und mehr Weißraum darüber zu haben. Eine nummerierte Überschrift und ein Absatz, der zufällig mit einer Zahl beginnt, sehen für Software identisch aus.
Um ein Dokument auszugeben, das das Original nachahmt, muss ein Werkzeug all dies zuerst richtig klassifizieren und dann auf ein völlig anderes Formatierungssystem mit eigenen Regeln zu Stilen, Rändern und Fluss abbilden. Fehler verstärken sich: eine falsch erkannte Überschrift ändert die Gliederung; eine falsch gelesene Tabelle bricht die Spalten darunter; eine Schriftersetzung lässt die Seite umbrechen. Deshalb ist „die Formatierung beibehalten“ meist die teuerste Anforderung, die Sie an ein PDF-Werkzeug stellen können, und deshalb braucht die Ausgabe oft mehr Nacharbeit, als Neuabtippen gekostet hätte.
Was sonst noch in der Datei steckt
Ein PDF ist ein Behälter, und ein Behälter hält mehr als die Seite, die Sie sehen. Wenn die Datei nach außen gesendet, öffentlich eingestellt oder in einen KI-Dienst hochgeladen wird, reist alles darin mit.
- Geerbte Metadaten. Der Export aus Word übernimmt in der Regel den Autorennamen, die Organisation und oft den ursprünglichen Ordnerpfad. Ein Pfad, der Mandant und Akte nennt, ist ein häufiger und stiller Leak.
- Schwarze Kästen, die nichts verbergen. Ein Rechteck über einem Namen deckt ihn visuell ab, während die Zeichen in der Datei bleiben und durch Markieren der Seite und Einfügen andernorts wiederhergestellt werden können.
- Die unsichtbare Textschicht. Bei einem gescannten und erkannten Dokument sitzt der erkannte Text unter dem Bild und reist mit der Datei, ob Sie von ihm wussten oder nicht.
- Frühere Versionen des Dokuments. PDFs können gespeichert werden, indem Änderungen ans Dateiende angehängt werden, sodass frühere Zustände innen bleiben und rekonstruiert werden können.
- Anmerkungen, Kommentare, Stempel und Formularfelder, in der Regel mit Name und Zeitstempel der Person, die sie hinzugefügt hat, einschließlich Feldern, die abgeflacht erscheinen oder nie angezeigt wurden.
- Eingebettete Bilder und Anhänge, die eigene Daten tragen. Ein Foto-Beweisstück kann Kamera, Datum und GPS-Koordinaten des Aufnahmeorts offenlegen.
Unschärfe und Verpixelung sind oft unzureichende Schutzmaßnahmen. Wo der versteckte Wert kurz und vorhersehbar ist (eine Kontonummer, ein Datum, eine nationale Identifikationsnummer), lässt sich die verdeckte Fassung oft umkehren, indem Kandidaten erzeugt und verglichen werden. Selbst ein wirklich undurchsichtiger Kasten hinterlässt eine Lücke bestimmter Breite.
Mehr dazu, einschließlich dessen, was das manche Organisationen an Bußgeldern und Sanktionen gekostet hat, finden Sie unter Welche versteckten Informationen stecken in Ihren Dokumenten?
Sie können nicht prüfen, was Sie nicht sehen. Der einzige zuverlässige Weg zu wissen, was ein Empfänger (oder ein KI-Dienst) erhält, ist, eine neue Datei zu erzeugen, die nur den Inhalt enthält, den Sie absichtlich hineinlegen.
Warum die KI-Verarbeitung von PDFs mehr kostet
LLMs lesen Token, grob gesagt Wortfragmente. Kosten, Geschwindigkeit und Kontextgrenzen werden alle in Token gemessen, und ein PDF ist ein teurer Weg, sie zu liefern.
- Die Datei muss vorverarbeitet werden, bevor das Modell denken kann. Klartext geht direkt ins Modell. Ein PDF muss erst geparst, extrahiert und oft repariert werden. Dieser Schritt geschieht entweder in der Pipeline des KI-Tools oder in Code, den das Modell schreibt und ausführt; in beiden Fällen zahlen Sie, bevor irgendeine Analyse beginnt.
- Gescannte Seiten erfordern OCR oder schlimmer: Bild-Token. Fehlt eine Textschicht, werden die Seiten erkannt oder dem Modell als Bilder übergeben. Bilder sind teuer: eine einzelne als Bild gerenderte Seite kann in der Größenordnung von tausend Token oder mehr verbrauchen, gegenüber wenigen Hundert für dieselbe Seite als Text. Bei einem zweihundertseitigen Beweisstück ist der Unterschied erheblich.
- Seitenelemente werden wie Inhalt abgerechnet. Laufende Kopf- und Fußzeilen, Seitenzahlen, Bates-Stempel, Vertraulichkeitshinweise und Unterschriftsblöcke wiederholen sich auf jeder Seite und verbrauchen auf jeder Seite Token, während sie fast keinen analytischen Wert tragen.
- OCR-Rauschen verbraucht ebenfalls Token. Irrläuferzeichen, zerbrochene Wörter, verwobene Spalten und falsch gelesene Symbole werden alle zu Token, die das Modell lesen muss, und sie verschlechtern die Qualität der Antwort.
- Fehler führen zu Wiederholungen. Wenn die Extraktion etwas Verworrenes liefert, ist die übliche Reaktion, eine andere Methode zu versuchen, die Seiten neu zu rendern oder die Frage erneut zu stellen. Jeder Versuch wird abgerechnet.
- Schlechte Struktur verschwendet Kontext. Ein Modell, das mit einer schlecht extrahierten Tabelle arbeitet, muss Denkaufwand in die Rekonstruktion stecken, was die Antwort verlängert und die Fehlerchance erhöht.
Ein Word-Dokument liegt in der Mitte: es hat echten Text und echte Struktur, sodass die Extraktion günstig und zuverlässig ist, auch wenn es weiterhin Änderungsverfolgung, Kommentare und Metadaten mitbringt. Sauberer Klartext oder Markdown ist der günstigste und vorhersehbarste Input überhaupt. Sie sehen genau, was das Modell sieht, und nichts Überflüssiges wird abgerechnet oder abgerufen.
Ein sinnvoller Workflow für PDFs und KI
- Prüfen Sie, welche Art von PDF Sie haben. Markieren Sie etwas Text, um zu sehen, ob er erkannt wird.
- Wenn eine erkennbare Textschicht vorhanden ist, extrahieren Sie sie. Holen Sie die Wörter in Text oder Markdown und lesen Sie, was herausgekommen ist, bevor Sie etwas anderes damit tun.
- Wenn es ein Scan ist, behandeln Sie den erkannten Text als Entwurf. Stichprobenartig Namen, Daten und Zahlen gegen die Seite prüfen, insbesondere alles, worauf Sie sich stützen wollen.
- Entfernen Sie, was die Aufgabe nicht braucht. Kopf- und Fußzeilen, Bates-Nummern und Seitenelemente kosten Token und erzeugen Rauschen.
- Ersetzen Sie Identifikatoren, bevor die Datei Ihren Rechner verlässt, mit konsistenten Platzhaltern, damit Beziehungen im Dokument erhalten bleiben. Das Modell muss selten wissen, wer die Parteien sind, um zu analysieren, worauf sie sich geeinigt haben.
- Senden Sie den vorbereiteten Text. Halten Sie den ursprünglichen PDF-Behälter vollständig aus dem KI-Workflow heraus.
CamoText liest PDFs mit erkannter Textschicht (neben Word, Excel und anderen gängigen Formaten), verarbeitet sie lokal auf Ihrem eigenen Gerät ohne Internetverbindung und schreibt eine völlig neue Ausgabe, die nur den sichtbaren Inhalt enthält, mit durch konsistente Platzhalter ersetzten Identifikatoren und ohne geerbte Metadaten. Das Ergebnis ist eine leichtere, günstigere, anonymisierte Datei für das KI-Tool Ihrer Wahl, und das Original verlässt nie Ihre Kontrolle.
Zusammenfassung
Ein PDF ist ein Bild einer Seite, manchmal mit einer angehängten Textschicht. Dieses Design macht es perfekt, um das Aussehen eines Dokuments zu bewahren, und unbequem für alles andere: Erkennung ist eine Vermutung, Umwandlung ist eine Rekonstruktion, Formatierung ist ein Erscheinungsbild statt einer Struktur, und der Behälter trägt still Daten, die die Seite nicht zeigt. Wenn ein PDF die Eingabe für eine KI-Analyse ist, kommt all das als Kosten, Rauschen und Exposition an.
Ein PDF vor der Analyse auf sauberen, geprüften, anonymisierten Text zu reduzieren, adressiert alle vier Probleme zugleich. Zum Workflow um diesen Schritt siehe Vertrauliche Dokumente für die KI-Prüfung vorbereiten.